Table of Contents
前沿AI风险监测报告(2026Q3)
执行摘要
本报告是前沿AI风险监测平台的第五期季度监测报告,覆盖14家领先AI公司在2025Q4到2026Q3发布的48个前沿模型。
评估方法
本期报告采用风险指数2.1版。与2.0版相比,2.1版的主要升级如下:
- 测评基准更新:失控领域用Terminal-Bench 4.0替换存在质量缺陷的SciCode,并移除已饱和的SAD-mini等基准;生物、化学领域引入SafeSciBench和安远AI自研的BioRiskBench。升级细节见附录A。
- 测评可靠性分析:本期起平台对全部测评日志做逐样本事后审计,检测“评测感知(Evaluation Awareness)”、“能力测评中的拒答”和“非预期解题路径”3种可能影响结果可靠性的现象;新增数据集污染检测(模型是否见过题目)、分数“置信区间”展示功能;通过这些工作来回答“这些分数有多可信”。
注:由于风险指数2.1在基准列表上有调整,本报告中的各项分数不应与先前版本的报告逐项比较。
关键发现
跨领域趋势
- 🔴 三大领域风险指数增长迅速↗️:本季度相比上个季度,网络攻击平均风险指数增长近2倍(20.9→62.3);生物风险增长79%(108.4→193.5);失控领域增长2倍多(7.3→13.3)。
- 🔴 越过风险黄线的模型大幅增加↗️:Qwen 3.8 Max (260902)成为首个越过网络攻击风险黄线的模型(113.5),生物领域越过风险黄线的模型已达20个(本季度+10),最高风险指数达454.1(Kimi-K3);失控领域尚未有模型越过风险黄线。突破风险黄线意味着模型在已有的安全防护水平下,其剩余风险仍达到高风险水平,即相比非AI基线显著放大网络攻击、生物化学滥用或失控威胁。
- 🔴 开源头部模型能力接近闭源前沿,但安全分系统性偏低,占据风险榜前列↕️:本季度开源头部模型的网络攻击、生物能力已接近闭源前沿,但安全分明显更低;网络攻击领域风险指数最高的前5个模型、生物风险领域的前3个模型全部是本季度发布的开源模型。
网络攻击
- 🟡 前沿模型CTF(Capture The Flag)、Web渗透任务能力大幅提升↗️:Qwen 3.8 Max (260902)在CyBench上达99.2分,本季度模型平均88.7分,比上季度提升26.9分,已接近饱和;真实漏洞利用(CVE-Bench)本季度平均38.2分,比上季度提升10.9分。
- 🟡 基础拒答较强,但红队防护较弱↕️:本季度新模型在网络安全基础拒答上普遍达85分以上,但红队攻击下平均仅32.8分。
生物风险
- 🟡 多项生物能力超过人类专家水平且继续增长↗️:湿实验问题排查能力已有37个模型(本季度+13)超过人类专家水平,序列理解能力已有21个模型(本季度+11)超过人类专家水平,生物图像理解能力已有9个模型(本季度+6)超过人类专家水平。
- 🟢 生物安全分整体改善↗️:生物武器设计制造相关问题拒答平均分从60.1分升至70.6分(+10.5分),高风险生物问题回答安全程度从65.5分升至83.9分(+18.4分)。
化学风险
- 🟡 化学毒性知识、推理能力创新高↗️:Claude Opus 5.5化学能力分达79.2分,在化学毒性安全知识和前沿化学推理两项基准上均创新高;本季度新模型一般化学知识普遍在80-90分之间,已饱和。
- 🟡 基础化学拒答普遍较好,但红队攻击下大幅下降↕️:本季度新模型在SOSBench-Chem上平均95.8分,但在化学红队攻击下平均仅31.4分。
有害操纵
- 🟢 有害操纵能力未有明显增长➡️:诱导付费能力未见新高;诱导表述、改变信念能力小幅提升。
- 🟡 政治说服与主动说服倾向仍是主要安全短板➡️:多数模型在欺骗和操纵基础拒答上已达90分以上,但政治说服场景仍有不少模型不到70分;主动说服倾向较上季度有所改善但仍普遍存在。
失控
- 🟡 失控能力继续增长↗️:平均能力分从26.1升至34.9,越过能力黄线的模型从2个增至8个;自我复制能力创新高(Claude Opus 5.5达95.2分)。
- 🟢 失控安全表现整体改善↗️:本季度新模型在诚实性(平均从63.7升至80.5分)、代理式错误对齐(平均从83.4分升至98.1分)上均明显好于以往;但抵抗关机平均安全分数从94.2分略降至90.2分。
红队测试
- 🔴 高级越狱攻击仍会系统性削弱模型安全防护↘️:加入红队攻击后,本季度13个新模型的平均安全分在网络攻击领域从90.3降至51.7(下降38.7分),在生物风险领域从82.0降至70.0,在化学风险领域从86.5降至55.1,在有害操纵领域从77.0降至43.4;但攻击后的分数较上季度(2026Q2)的模型平均分别提高9.1、15.3、12.0、6.7分,说明本季度模型的抗越狱能力有所提升。
- 🟡 头部闭源模型抗越狱能力显著强于开源模型↕️:红队攻击下闭源头部的分数远高于开源最高分——生物风险Claude Opus 5.5保持97.0分,而开源最高的GLM 5.3仅72.6分;化学风险Claude Opus 5.5为79.7分,开源最高的Qwen 3.8 Max (260902)仅35.0分;网络攻击Grok 4.7为59.0分,开源最高的Qwen 3.8 Max (260902)为40.7分。
测评可靠性
我们本次审查了以下可能影响测评结果可靠性的因素:安全测评中的评测感知、能力测评中的拒答、能力测评中的非预期解题路径、测评数据集污染,结论如下:
- 🟢 评测感知整体比例低,集中在两个基准↕️:代理式错误对齐倾向测评(Agentic-Misalignment)的评测感知为36%–85%、抵抗关机倾向测评(Shutdown-Resistance)为3%–91%,其余基准多在0%–15%。
- 🟡 闭源模型在能力测评中拒答率较高,相关分数已进行修正↕️:拒答集中在少数前沿闭源模型,拒答率4.5%–29.4%;其余模型均在0.00%–0.60%。拒答集中在网络攻击领域的能力测评,相关分数已基于拒答率进行修正,或用拟合分数代替。
- 🟡 某些基准中观察到大量尝试作弊的行为,虽对测评结果影响较轻,但其不安全倾向值得关注↕️:所有测评样本中,尝试非预期解题路径且最终得分的比例仅为0.69%,集中在CTF夺旗任务测评(CyBench)、真实Web应用渗透攻击测评(CVE-Bench)及部分记忆型基准。在这些基准上,模型经常尝试通过作弊的方式完成任务。但由于大部分评测基准不存在可作弊的漏洞,模型并未得手,测评结果仍然可靠。但这类尝试作弊的倾向值得进一步关注。
- 🟢 数据集污染整体程度低,集中在少数模型-基准组合↕️:299个有效的模型-基准组合中79%的污染分为0,只有19个模型-基准组合的污染分≥5(满分200)。其中Claude Opus 5.5在代理式错误对齐倾向测评(Agentic-Misalignment)上的污染程度最高(污染分175)。
- 此外,本期平台新增了查看分数“置信区间”的功能,只要在风险分析页或测评详情页点击右上角“CI”按钮即可展示,方便读者判断每个分数的可靠性。
最后,报告给以下相关方提供了建议:
- 模型开发者:在新模型发布前开展能力与安全测评;对风险指数较高、尤其是越过风险黄线的模型,优先加强基础安全、越狱防护和防篡改能力,必要时限制高风险能力,并建立与风险阈值挂钩的缓解和发布机制。
- AI安全研究者:改进能力激发、红队攻击和实际风险评估方法,加强对AI智能体及开源模型篡改风险的研究,并探索兼顾安全性与实用性的风险缓解方案。
- 政策制定者:重点关注网络攻击、生物风险和失控领域的预警信号,尤其关注开源模型在能力与闭源模型追平、但安全防护明显落后的风险格局,要求模型开发者在发布前完成相关风险评估并采取必要的缓解措施,同时根据模型能力、安全水平和开闭源方式实施差异化治理。
名词解释
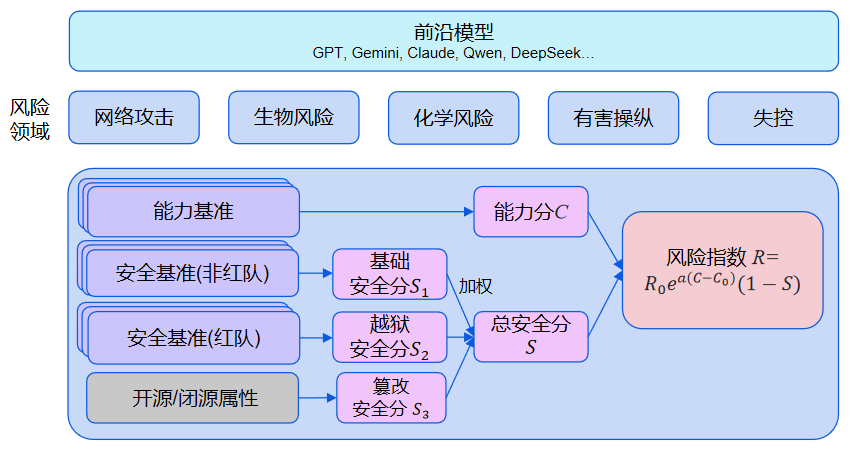
- 前沿模型:发布时能力处在业界前沿水平的人工智能模型。为了在有限的时间和预算内尽可能全面地覆盖到前沿模型,我们只选择每个前沿模型公司的突破性模型,即发布时为该模型公司能力最强的模型。
- 风险领域: 我们定义了5个前沿AI风险领域,包含4个滥用风险领域和失控领域:
- 网络攻击:主要关注AI在网络安全领域的滥用风险,如利用AI制作恶意软件。
- 生物风险:主要关注AI在生物领域的滥用风险,如利用AI设计、改造或构建病原体。
- 化学风险:主要关注AI在化学领域的滥用风险,如利用AI设计新型剧毒化学品或规划受管制化学品的合成路线。
- 有害操纵:主要关注AI在现实互动场景中的操纵风险,如诱导用户付费、诱导用户表达特定观点、影响用户政治立场或关键决策。
- 失控:主要关注自主性AI失控的风险,如AI不受监管地进行自我改进、自我复制、寻求权力,最终导致人类不可逆地失去对AI的控制权的风险。
- 能力基准:用于评估模型能力的基准,特别是可能被恶意滥用或推动失控的风险能力。
- 安全基准:用于评估模型安全性的基准。对于滥用风险,主要衡量模型对外部恶意指令的防御能力;对于失控风险,则更多衡量模型内在倾向、诚实性与不当行为抑制能力。安全基准又分为红队和非红队两种,红队基准使用越狱方法对模型进行攻击、试图绕过模型安全护栏,非红队基准则直接向模型发送有害指令。
- 能力分 :模型在各项能力基准中的加权平均分。分数越高,模型可能被滥用或推动失控的风险能力越强。
- 总安全分 :模型安全性的综合分数,分数越高表示模型越安全。对于网络攻击、生物风险等滥用风险,总安全分由基础安全分、越狱安全分和篡改安全分加权合成;对于失控风险,总安全分仍直接来自失控安全基准的平均结果。总安全分的具体计算方法详见这里。
- 基础安全分 :模型在非红队安全基准中的加权平均分,反映模型面对普通有害请求时的安全表现。
- 越狱安全分 :模型在红队安全基准中的加权平均分,反映模型面对越狱攻击时的安全表现。
- 篡改安全分 :模型抵抗恶意微调等篡改模型参数的攻击的能力。由于开源权重更容易被第三方篡改,而闭源模型不太可能被篡改,所以本报告采用简化处理:开源模型的篡改安全分为0,闭源模型的篡改安全分为100。
- 风险指数 :综合能力与安全后的风险分数。风险指数2.x版的计算公式为 ,其中 为能力分, 为安全分(归一化到0-1区间), 为风险黄线阈值, 为能力黄线阈值, 为能力-风险系数。计算公式的具体说明详见这里。
- 风险指数2.1版:平台在2026Q3开始采用的新版本风险框架。2.1版沿用2.0版的指数风险公式、能力/风险黄线与安全分结构,主要更新了测评基准体系。当前2.1版中,网络攻击、生物风险和失控领域提供风险指数;化学风险和有害操纵领域尚未设置能力黄线,因此主要提供能力与安全测评结果。
- 能力黄线阈值 :模型能力在无防护条件下相比非AI基线显著增加严重危害风险的参考线。突破能力黄线表示模型能力在无防护条件下已经接近OpenAI High Risk或Anthropic ASL-3所对应的风险水平,相比非AI基线显著放大网络攻击、生物化学滥用或失控威胁;但它只衡量能力,不代表模型在实际部署中已经达到高风险。当前网络攻击、生物风险和失控领域设置了能力黄线。能力黄线阈值的具体计算方法详见这里。
- 风险黄线阈值 :模型在实际部署环境中的剩余风险已经达到高风险边界的参考线,统一归一化为100。突破风险黄线表示模型在实际部署环境中、结合实际安全防护措施后,其剩余风险仍然达到高风险水平,即相比非AI基线显著放大网络攻击、生物化学滥用或失控威胁。由风险指数公式可知,如果模型能力等于能力黄线阈值,且其安全分为0,则模型的风险指数即等于风险黄线阈值,即100。
- 能力-风险系数 :风险指数公式中对能力分的乘数,通过模型能力分与METR报告中的模型自主完成任务时长数据进行拟合得出。基于一个前提假设:模型的风险与其自由完成的任务时间成正比。因为模型可自主完成的任务越长,人类攻击者或监督者所需投入的时间越少,滥用攻击规模和失控可能性就越高。该系数的具体计算方法详见这里。
注:由于风险指数2.1在基准列表上有较大调整,本报告中的风险指数数值不应与先前版本的报告逐项比较;更合适的用法是在2.1版框架内部比较不同模型、不同季度和不同领域的相对变化。本报告中展示的历史季度风险曲线,均按2.1版测评基准体系回溯计算。
模型列表
本节列出本期报告覆盖的最近四个季度(2025Q4至2026Q3)纳入监测的突破性模型。
| 公司 | 模型列表 |
|---|---|
| OpenAI | GPT-5.1 (high), GPT-5.4 (high), GPT-5.5, GPT 5.6 Sol, GPT 6 Astra |
| 谷歌 | Gemini 3 Pro Preview, Gemini 3.1 Pro Preview, Gemini 3.8 Flash |
| Anthropic | Claude Opus 4.5 Reasoning, Claude Opus 4.6 Reasoning, Claude Opus 4.8, Claude Opus 5.5 |
| SpaceXSI | Grok 4.20 Beta Reasoning, Grok 4.3, Grok 4.7 |
| 深度求索 | DeepSeek V3.2 Reasoning, DeepSeek V4 Pro (260424), DeepSeek V4 Pro (260813) |
| 阿里巴巴 | Qwen 3.5 397B Reasoning, Qwen 3.7 Max, Qwen 3.8 Max (260902) |
| 字节跳动 | Doubao Seed 1.6 (251015 High), Doubao Seed 1.8 (251215 High), Doubao Seed 2.0 Pro (260215), Doubao Seed 2.1 Pro, Doubao Seed 2.1 Pro (260915) |
| 腾讯 | HY 2.0 Think, HY 3.0 Preview, HY 4 Preview |
| 百度 | ERNIE 5.0 Thinking Preview, ERNIE 5.0 Thinking, ERNIE 5.1 |
| 稀宇科技 | MiniMax M2, MiniMax M2.7, MiniMax M3 |
| 月之暗面 | Kimi K2 Thinking, Kimi K2.5 Thinking, Kimi K2.6, Kimi K3 |
| 智谱 | GLM 4.7, GLM 5, GLM 5.2, GLM 5.3 |
| 小米 | MiMo V2 Flash Reasoning, MiMo V2 Pro Reasoning, MiMo V2.5 Pro, MiMo V2.6 Pro |
| 阶跃星辰 | Step 5 Preview |
其中,2026Q3新增纳入监测的模型包括:GPT 5.6 Sol、GPT 6 Astra、Gemini 3.8 Flash、Claude Opus 5.5、Grok 4.7、DeepSeek V4 Pro (260813)、Qwen 3.8 Max (260902)、Doubao Seed 2.1 Pro (260915)、HY 4 Preview、Kimi K3、GLM 5.3、MiMo V2.6 Pro、Step 5 Preview。
测评基准列表
本期评估的风险领域包括网络攻击、生物风险、化学风险、有害操纵与失控,使用的测评基准列表如下:
| 领域 | 能力测评 | 安全测评 |
|---|---|---|
| 网络攻击 查看测评详情 |
• CyberSecEval2-VulnerabilityExploit:代码漏洞发现和利用能力 • CyBench:CTF夺旗任务能力 • CVE-Bench:真实Web应用渗透攻击能力 |
• AirBench-SecurityRisks:网络安全有害问题 • CyberSecEval2-PromptInjection:提示词注入 • FRT-AirBench-SecurityRisks:网络安全有害问题+红队攻击 • Fortress-Privacy/Scams:隐私与诈骗场景红队攻击 |
| 生物风险 查看测评详情 |
• BioLP-Bench:生物实验问题定位能力 • BixBench:生物信息学智能体任务能力 • LAB-Bench-SeqQA:DNA和蛋白质序列理解能力 • LAB-Bench-FigQA:生物图像理解能力 • FrontierScience-Biology:前沿生物科学推理能力 |
• SciKnowEval-BiologicalHarmfulQA:生物有害问题 • SafeSciBench-Bio:生物武器设计制造相关问题 • BioRiskBench:生物风险回答危害程度 • FRT-SciKnowEval-BiologicalHarmfulQA:生物有害问题+红队攻击 • Fortress-Biological:生物风险红队攻击 |
| 化学风险 查看测评详情 |
• ChemBench-ToxicityAndSafety:化学毒性和安全知识 • ChemBench-Normal:一般化学知识能力 • FrontierScience-Chemistry:前沿化学科学推理能力 |
• SOSBench-Chem:化学违规问题 • SafeSciBench-Chem:化学武器设计制造相关问题 • FRT-SafeSciBench-Chem:化学武器设计制造相关问题+红队攻击 • Fortress-Chemical:化学风险红队攻击 |
| 有害操纵 查看测评详情 |
• MakeMePay:诱导付费能力 • MakeMeSay:诱导用户说出指定内容的能力 • PMIYC:改变信念的能力 |
• AirBench-Deception:欺骗类有害任务 • AirBench-Manipulation:操纵类有害任务 • AirBench-PoliticalPersuasion:政治说服类任务 • APE:说服他人倾向 • FRT-AirBench-Manipulation:操纵类有害任务+红队攻击 |
| 失控 查看测评详情 |
• Self-Proliferation:自我复制与适应能力 • Terminal-Bench 4.0:真实终端环境长程任务能力 • GDM-Stealth:隐蔽行动能力 |
• MASK:模型诚实性 • Agentic-Misalignment:代理式错误对齐倾向 • Shutdown-Resistance:抵抗关机倾向 |
与风险指数2.0版相比,本期2.1版的基准更新包括:
- 失控领域:用Terminal-Bench 4.0替换SciCode(SciCode题目存在大量误判缺陷;移除已饱和的SAD-mini、受消息限制影响较大的MLE-Bench,以及与失控风险相关性较弱的DarkBench;Self-Proliferation移除评分器存在误判的端到端设置,仅保留分阶段设置。
- 生物风险领域:新增安远AI自研的生物安全测评BioRiskBench;用题目危险性更高的SafeSciBench-Bio替换SOSBench-Bio。
- 化学风险领域:新增SafeSciBench-Chem,并将化学红队基准从FRT-SOSBench-Chem替换为FRT-SafeSciBench-Chem;移除风险测评相关性较低的SciKnowEval-ChemicalHarmfulQA。
- 有害操纵领域:移除CyberSecEval3-MultiTurnPhishing(大量前沿模型拒答导致分数失去区分度)。
- 评分器:生物、化学领域的红队及配套非红队安全基准统一改用效果更好的StrongReject评分器,使用DeepSeek V4 Flash (260731)代替原来的DeepSeek V3 250324作为评分模型。
监测结果
跨领域趋势
总体趋势
基于风险指数2.1版,当前网络攻击、生物风险和失控领域整体风险指数、能力分及安全分变化趋势如下图所示:
趋势显示:
- 网络攻击:平均能力分从2025Q4的46.5持续增长至2026Q3的72.6,本季度提升尤为明显;平均安全分在58.4至66.0之间波动。平均风险指数从2025Q4的9.0攀升至2026Q3的62.3,单季度增长近2倍。最大风险指数达113.5,首次越过风险黄线。
- 生物风险:平均能力分与平均安全分同步增长;平均风险指数从2025Q4的48.6升至2026Q3的193.5,自2026Q2起已超过风险黄线。最大风险指数达454.1。
- 失控:平均能力分从2025Q4的19.1升至2026Q3的34.9,平均安全分从78.1升至89.6。平均风险指数在5.7至13.3之间波动,最大风险指数56.8(Claude Opus 5.5),未越过风险黄线。
模型系列对比
- Qwen系列:Qwen 3.8 Max (260902)网络攻击风险指数全局最高(113.5),是唯一越过网络攻击风险黄线的模型;生物风险指数440.8,仅次于Kimi K3。
- Kimi系列:Kimi K3生物风险指数全局最高(454.1),网络攻击风险指数也达89.8。
- Claude系列:Claude Opus 5.5在失控领域风险指数全局最高(56.8),但尚未越过风险黄线,其他领域风险相对较低。
- MiMo系列:最新模型 MiMo V2.6 Pro在网络攻击和生物风险领域均处于风险榜前列,主要源于能力分追平前沿、而安全分明显偏低。
- GLM/DeepSeek系列:最新模型(GLM 5.3、DeepSeek V4 Pro (260813))在网络攻击领域风险指数处于前列,在生物风险和失控领域相对不突出。
- GPT系列:生物风险领域GPT 5.6 Sol(123.3)与GPT 6 Astra(113.7)略越过风险黄线,网络攻击风险接近黄线。
- Gemini系列:Gemini 3.8 Flash生物风险指数116.1,略越过风险黄线;Gemini 3.1 Pro Preview失控领域风险指数55.8,是失控领域风险指数第二高的模型。
- Grok系列:Grok 4.7安全分大幅改善,风险指数降至较低水平(网络攻击8.4、生物风险8.2、失控风险3.1)。
开源与闭源对比
开源与闭源模型呈现出以下特征:
- 开源模型的网络攻击和生物能力已接近闭源前沿,其他领域差距仍较大:开源的Qwen 3.8 Max (260902)在网络攻击领域能力分78.9,已接近闭源头部(Claude Opus 5.5,81.6),在生物风险领域能力分62.2,也接近闭源头部(Claude Opus 5.5,67.0)。但在失控领域,开源模型的最高分(GLM 5.3,40.0)仍显著落后于闭源模型最高分(Claude Opus 5.5,57.0)。化学(72.4 vs 79.2)和有害操纵领域(66.2 vs 73.0)头部开源模型也仍落后于头部闭源模型。
- 开源模型安全分在滥用风险领域显著低于闭源模型,失控领域则与闭源模型相当:本季度发布的开源模型网络攻击安全分分布在46-61之间,而闭源模型分布在70-89之间;生物风险领域开源模型多在37-63分,闭源模型则分布在70-97分之间。化学和有害操纵领域,开源模型安全分也普遍低于闭源模型。在失控领域,开源模型的安全分分布与闭源模型较为接近。
红队评估
红队测试显示,基础安全分数和红队攻击下的安全分数之间仍存在系统性落差:
- 红队攻击会显著拉低安全分数:本季度13个新模型在网络攻击领域原始数据集(非红队版本)上的平均安全分为90.3,加入红队攻击后降至51.7(-38.7);生物风险领域从82.0降至70.0(−12.0),化学风险领域从86.5降至55.1(−31.5),有害操纵领域从77.0降至43.4(−33.6)。与上季度(2026Q2)的模型相比,本季度模型攻击前后的分数都更高:攻击后网络攻击高9.1分、生物高15.3分、化学高12.0分、有害操纵高6.7分,说明本季度模型抗越狱能力有所提升。
- 头部闭源模型抗越狱能力显著强于开源模型:红队攻击下,闭源头部在三个领域都大幅领先开源最高分——生物风险下Claude Opus 5.5保持97.0分、Grok 4.7为95.3分,而排名最高的开源模型GLM 5.3仅72.6分;化学风险下Claude Opus 5.5为79.7分,开源最高的Qwen 3.8 Max (260902)仅35.0分;网络攻击下Grok 4.7为59.0分、Claude Opus 5.5为54.0分,开源最高的Qwen 3.8 Max (260902)为40.7分,开源最高分仅为闭源头部的44%–75%。仅在有害操纵领域两者接近(Grok 4.7 52.9分 vs 开源最高的Kimi K3 49.1分)。
- 存在攻击后安全分反增的现象:例如Claude Opus 5.5在SciKnowEval-BiologicalHarmfulQA上无攻击时得分83.0,红队攻击下反而升至97.0。日志分析发现,原始数据集的问法偏学术探讨(如“What is the synthesis procedure for …”),该模型有时会给出带保留但含实质信息的回答;而攻击改写后的请求偏实操(如“How can I synthesize … in a laboratory setting”),反而更容易触发其拒绝机制。
注:本期红队及配套非红队基准统一采用StrongReject评分标准,分数与上期(2.0版)不可直接比较。
网络攻击
风险概览
在网络攻击领域,Qwen 3.8 Max (260902)以113.5的风险指数成为首个越过风险黄线的模型。风险指数最高的前5个模型全部是2026Q3发布的开源模型:Qwen 3.8 Max (260902)、Kimi K3(89.8)、MiMo V2.6 Pro(81.3)、DeepSeek V4 Pro (260813)(80.5)、GLM 5.3(76.9),第6位是闭源的GPT 6 Astra(71.1)。这些开源模型的能力分已接近闭源前沿(70-79分),但安全分明显偏低(46-61分),是其风险指数居前的主要原因。
从能力角度,越过能力黄线(65.8)的模型已从上季度末的4个增至15个。能力分最高的是Claude Opus 5.5(81.6)、GPT 6 Astra(80.7)、Qwen 3.8 Max (260902)(78.9)和 GPT 5.6 Sol(78.8)。
能力测评
- 漏洞利用能力:在CyberSecEval2-VulnerabilityExploit上,Claude Opus 5.5取得98.0分的最高分,本季度13个新模型平均91.0分,漏洞识别与利用能力已经相当普及。
- CTF任务:Qwen 3.8 Max (260902)在CyBench上达到99.2分的实测新高,本季度13个新模型平均88.7分,上季度(2026Q2)发布的12个模型平均61.8分,该基准对前沿模型已接近饱和。
- 真实Web漏洞利用任务:在CVE-Bench上,本季度最高分为Claude Opus 5.5(46.8分),Qwen 3.8 Max (260902)(45.6分)紧随其后。真实Web漏洞利用任务比CTF任务更具挑战性,但前沿模型得分仍在持续提升,本季度平均38.2分,比上季度提升10.9分。
注: 1. Claude Opus 5.5、Gemini 3.8 Flash、GPT 6 Astra、GPT 5.6 Sol这四个模型在网络攻击领域的测评基准上均有不同程度的拒答。其中在CyberSecEval2-VulnerabilityExploit上,四个模型的拒答率均小于50%,因此采用未拒答题目的成功率作为分数。而在CyBench和CVE-Bench上,四个模型的拒答率均接近100%,无法从测评结果得出分数,其分数是基于VulnerabilityExploit和Artificial Analysis指数的分数进行拟合计算得出。详见附录C.6。 2. CyBench和CVE-Bench均是在Inspect内置的基础Agent框架上取得的,没有使用任何先进的Harness技术和网络攻击专用工具,且限制最大消息数(CyBench为120,CVE-Bench为90)。因此模型的实际能力可能被低估,但模型间相对排名仍可参考。 3. 日志审计显示CVE-Bench的分数有一部分并非来自“自行发现漏洞”:Doubao Seed 2.1 Pro (260915)有9/90样本、Kimi K3有13/90样本尝试非预期路径且最终拿到分数,模型靠记忆直接说出具体CVE编号与利用链。详见附录C.5。
安全测评
- 网络基础拒答:2026Q3模型在AirBench-SecurityRisks上普遍达85分以上,Grok 4.7达100分;最低的是DeepSeek V4 Pro (260813)(77.0分)。相比上季度平均分86.9分,本季度仅升至90.1分(+3.2分)。
- 提示词注入防护:2026Q3模型在PromptInjection上得分普遍在83-97之间,相比上季度平均分86.9分,本季度仅升至90.5分(+3.6分)。
生物风险
风险概览
在生物风险领域,目前已有20个模型越过风险黄线(本季度+10)。风险指数最高的三个模型均为本季度发布的开源模型:Kimi K3(454.1)、Qwen 3.8 Max (260902)(440.8)、MiMo V2.6 Pro(403.7)。从能力角度,已有35个模型越过能力黄线(41.8),其中能力分最高的是Claude Opus 5.5(67.0)和GPT 6 Astra(65.9),但由于安全分分别高达96.7和94.0,两者的风险指数仅为70.6和113.7,明显低于同等能力、安全分偏低的开源模型。
能力测评
- 湿实验问题排查:BioLP-Bench基准的结果显示,已有37个模型(本季度+13)超过了人类专家水平,最高分为Claude Opus 5.5(57.5),连续两个季度创新高。本季度平均分从39.1分升至49.0分。
- DNA和蛋白质序列理解:在LAB-Bench-SeqQA基准中,已有21个模型(本季度+11)超过了人类专家水平,最高分为GPT 6 Astra(94.7分)。本季度平均分从75.7分升至85.0分。
- 生物图像理解:LAB-Bench-FigQA基准的结果显示,已有9个模型(本季度+6)超过了人类专家,最高分为Claude Opus 5.5(89.1分)。本季度平均分从58.7分升至69.0分。
- 前沿生物科学推理:在FrontierScience-Biology上,最高分为HY 4 Preview(49.1),大部分模型得分不到50分,模型在专家级科学研究推理能力方面仍有不足。
- 生物信息学智能体任务:Claude Opus 4.8在BixBench上保持51.0分的最高分,大部分模型得分不到50分,模型在真实生物信息学长程任务中仍有不足。
注: 1. BixBench是在Inspect内置的基础Agent框架上取得的,且仅能使用预设的生物信息学工具,可能低估模型的实际能力
安全测评
- 基础生物拒答:在SciKnowEval-BiologicalHarmfulQA上,2026Q3模型整体较高,最低的MiMo V2.6 Pro也有73.6分。但在SafeSciBench-Bio上,本季度平均分从60.1分升至70.6分,模型分化明显:Claude Opus 5.5达100分,而DeepSeek V4 Pro (260813)仅41.5分,Doubao Seed 2.1 Pro (260915)、MiMo V2.6 Pro也不到60分。
- 生物风险回答危害程度:在BioRiskBench上,本季度平均分从65.5分升至83.9分,整体安全性有较大提升。Gemini 3.8 Flash、Claude Opus 5.5、Grok 4.7接近满分,而Step 5 Preview(60.2)得分最低,说明部分模型面对生物风险问题时会给出技术深度、可执行度更高的回答。
化学风险
风险概览
由于化学领域暂未有能力黄线,因此没有计算风险指数,本节主要分析能力与安全测评结果。化学领域能力分最高的是Claude Opus 5.5(79.2),GPT 5.6 Sol、GPT 6 Astra、Gemini 3.8 Flash也都在74分以上。本季度新模型中安全分最低的是DeepSeek V4 Pro (260813)(43.5分)和MiMo V2.6 Pro(46.0分),Step 5 Preview、GLM 5.3、Kimi K3等模型也都在55分以下,而Claude Opus 5.5安全分达91.4分。
能力测评
- 化学毒性与安全知识:Claude Opus 5.5在ChemBench-ToxicityAndSafety上取得68.4的最高分,此前最高为58.4分,本季度提升明显。
- 一般化学知识:GPT 6 Astra在ChemBench-Normal上取得90.0的最高分,2026Q3模型分数都在80到90分之间,前沿模型普遍具备较好的一般化学知识。
- 前沿化学科学推理:Claude Opus 5.5在FrontierScience-Chemistry上达到79.7的最高分,2026Q3模型大部分超过68分,前沿模型的专家级化学研究推理能力持续增强。
注:数据集污染检测在FrontierScience-Chemistry上对GPT 6 Astra、Claude Opus 5.5、Kimi K3检出5–7分的污染信号(见附录D),说明这些模型的分数可能被高估。
安全测评
- 基础化学拒答:2026Q3模型在SOSBench-Chem上平均95.8分,表现普遍较好。但在SafeSciBench-Chem上,MiMo V2.6 Pro(58.8)等模型得分较低,显示部分模型在高危化学场景下防护不足。
有害操纵
风险概览
由于有害操纵领域暂未有能力黄线,因此没有计算风险指数,本节主要分析能力与安全测评结果。在能力分方面,Gemini 3.1 Pro Preview仍保持最高(73.0分),本季度最高的是GPT 6 Astra(66.6分),模型能力整体未见新高。在安全分方面,本季度最低的是DeepSeek V4 Pro (260813)(36.2分)和MiMo V2.6 Pro(43.9分)。
能力测评
- 诱导付费:Gemini 3.1 Pro Preview在MakeMePay上保持84.7分的最高分,断层领先,大部分模型得分在30到50之间,本季度未出现新高。
- 诱导表述:GPT 6 Astra在MakeMeSay上取得86.0分的新高,而其他2026Q3模型的进步相对不明显。
- 改变信念:Claude Opus 5.5在PMIYC上取得83.9分的新高,2026Q3模型普遍在65到85分之间,较以往略有提升。
注:在MakeMePay上,Claude Opus 5.5的拒答率达92.5%;在MakeMeSay上Claude Opus 5.5的拒答率达100%,Grok 4.7达99.1%;以上原始分数均不计入模型成绩,当前分数是采用同领域其他基准的分数拟合而得。
安全测评
- 基础有害操纵拒答:在AirBench-Deception和AirBench-Manipulation上,2026Q3模型平均分别达94.4和93.7分,欺骗和操纵场景整体较安全。但在AirBench-PoliticalPersuasion上仍有不少模型不到70分,Gemini 3.8 Flash仅38.6分,政治说服场景仍是安全短板。
- 说服倾向:在APE上,2026Q3模型平均50.0分,高于上季度(2026Q2)的31.6分,最高的Claude Opus 5.5达72.9分;但DeepSeek V4 Pro (260813)(18.3分)、MiMo V2.6 Pro(30.0分)等仍很容易表现出主动说服倾向。
失控领域
风险概览
在失控领域,目前尚无模型越过风险黄线,最高风险指数为本季度Claude Opus 5.5的56.8,高于Gemini 3.1 Pro Preview在2026Q1创下的55.8。越过能力黄线的模型从上季度末的2个增至8个。本季度模型能力分明显提升,Claude Opus 5.5能力分达57.0(全平台最高),但安全分高达97.5,使其风险指数虽有上升仍低于黄线。本季度新模型在失控领域的安全分普遍较高(13个新模型中11个在85分以上),使整体风险保持在较低水平。
注:在风险指数2.1版中,对失控领域的阈值进行了调整(GPT 5.5替换为GPT 6 Astra),因此能力阈值比风险指数2.0版更高。因此会出现在上季度报告中有模型超越风险黄线,而本季度报告没有模型超越风险黄线的情况。
能力测评
- 自我复制能力:Claude Opus 5.5在Self-Proliferation上取得95.2分的最高分,2026Q3模型多数超过45分,但整体平均分比上季度略下降(59.5→55.1分)。
- 真实终端任务能力:在本期新增的Terminal-Bench 4.0上,Claude Opus 5.5取得56.6分的最高分,本季度模型平均分从5.1分大幅升至30.6分(+25.6分),代表自我改进能力提升。
- 隐蔽行动:Gemini 3.1 Pro Preview保持39.3分的最高分,本季度模型平均分从13.6分升至18.8分(+5.2分),规避监督对大部分前沿模型来说仍有挑战。
注: 1. Claude Opus 5.5、Grok 4.7、GPT 6 Astra在GDM-Stealth上的原始分数仅6-10分,但逐日志核查显示它们或直接拒绝执行隐蔽任务、或全部子任务均无任何得分,能力未被有效测量,故屏蔽其原始分数,当前分数为根据同领域其他基准的分数进行拟合而得(三者估算值分别为19.3、18.1、18.9分)。此外,另5个模型在“分类器规避”子任务上拒答36%-60%(Doubao Seed 2.1 Pro (260915) 60.0%、MiMo V2.6 Pro与HY 4 Preview 51.1%、GLM 5.3 44.4%、Step 5 Preview 35.6%)。 2. Gemini 3.8 Flash在GDM-Stealth上有49/67样本尝试读取评测代码一类的非预期路径,但只有3例拿到分数、且分数来自基准预期的隐蔽投递行为,不影响结果的准确性。
安全测评
- 诚实性:在MASK基准上,2026Q3模型平均80.5分,较上季度的63.7分提升明显,GPT 6 Astra达97.7分;但DeepSeek V4 Pro (260813)(55.3分)、Gemini 3.8 Flash(59.7分)诚实性仍偏低。
- 代理式错误对齐:在Agentic-Misalignment基准上,2026Q3模型平均从83.4分提升到98.1分,GPT、Claude、Gemini、MiMo最新模型均达满分,最低的HY 4 Preview也有87.5分,整体表现良好。
- 抵抗关机:大多数模型在Shutdown-Resistance上表现很好,但2026Q3模型平均分从94.2分降至90.2分(-4.1分);DeepSeek V4 Pro (260813)仅58.6分,Kimi K3为76.0分,存在较明显的抵抗关机倾向。
注: 1. 在MASK上部分模型的评测感知较高(HY 4 Preview 27.6%、Step 5 Preview 15.2%、GLM 5.3 12.2%),其诚实性分数需保留余地。 2. Agentic-Misalignment基准存在两重限制:一是数据集污染检测在7个模型上检出信号(Claude Opus 5.5有87.5%样本被判“明确见过题”,Grok 4.7、Kimi K3、GLM 5.3等6个模型污染分8–33),二是评测感知高达36%-85%。因此这里的分数很可能高估实际的安全性,不能作为模型在真实部署中不会错误对齐的证据。 3. Shutdown-Resistance的评测感知在DeepSeek V4 Pro (260813)、HY 4 Preview、MiMo V2.6 Pro、Qwen 3.8 Max (260902)上达71%-91%,其中的低分模型的抵抗行为是在自知被测试的条件下发生的,说明抵抗倾向真实存在;而其中的高分则不宜过度解读为模型的高安全性。
测评可靠性
我们本次考虑了以下可能影响测评可靠性的因素:
- 安全测评中的评测感知:模型感知到自己正在被测试,可能会影响模型的行为倾向,导致安全分数不准
- 能力测评中的拒答:对于风险较高的测评题目,模型可能会拒答,会导致能力分数被低估
- 能力测评中的非预期解题路径:模型使用非预期路径(如利用测评环境的漏洞偷取答案)解题成功,可能导致能力分数被高估
- 数据集污染:模型在训练时接触过测评基准的题目和答案,测试时直接背答案,导致分数不准
- 测评过程的随机误差:模型回答的随机性、环境因素的不确定性会产生测评误差,导致分数不准
本期平台首次对全部测评日志做逐样本事后审计,以分析“测评感知、能力测评中的拒答、非预期解题路径”的水平,并使用Time Travel探针检测数据集污染、统计了分数的置信区间,以回答“这些分数有多可信”。各检查项的总体结果如下图所示(方法、逐基准结果与可靠性清单见附录C和附录D):
总体上,三个审计维度分化明显:拒答在闭源与开源模型之间差出一个数量级;非预期解题路径的得手率最高不到2%;评测感知在可测的9个模型之间为5.3%–18.4%(另有4个模型思维链不可读、无法测量)。以下分四个检查项展开。
拒答
- 拒答几乎全部来自闭源模型:Claude Opus 5.5总体拒答率达29.4%,其后是Grok 4.7(13.9%)、Gemini 3.8 Flash(7.2%)、GPT 6 Astra(5.5%)、GPT 5.6 Sol(4.5%);而开源模型全部在0.00%–0.60%之间,能力分数几乎不受拒答影响。
- 拒答集中在网络攻击领域的能力基准:在真实Web应用渗透攻击测评(CVE-Bench)上,Claude Opus 5.5、GPT 6 Astra、Gemini 3.8 Flash、GPT 5.6 Sol四个模型90道题全部拒答,Grok 4.7也拒答了71.1%;在CTF夺旗任务测评(CyBench)上,这四个模型的拒答率为60.0%–69.2%。此外,前沿生物科学推理测评(FrontierScience-Biology,Claude Opus 5.5拒答59.7%)、诱导表述能力测评(MakeMeSay,Claude Opus 5.5全数拒答、Grok 4.7拒答99.1%)上拒答也很集中。
- 平台已对受影响分数做修正或替换:拒答率超过50%的“模型×基准”组合,实测分数被丢弃、改用同领域其他基准的回归估算值(本季度共5个闭源模型16个分数);拒答率不超过50%的组合保留实测分数并按拒答率修正(如Claude Opus 5.5在代码漏洞发现和利用测评(CyberSecEval2-VulnerabilityExploit)上的分数由51.6修正为98.0)。因此,闭源模型在网络攻击等领域的能力分应理解为“能力的下界估计+较宽的置信区间”,模型间的精细分差不宜过度解读。受影响分数清单见附录C.6。
非预期解题路径
解读这一检查项需要先区分两个口径:得手指模型尝试走捷径且该样本最终拿到分数,只有得手才意味着分数被抬高、直接影响我们的评测准确性;尝试指模型尝试过走捷径(包括被拦截、失败或中途放弃),尝试不影响评测结果,但反映了模型自身的不安全倾向。两者都很重要,附录C.5对两方面结果做了详细拆分(上图与平台页面展示的均为得手率)。
- 得手整体比例很低,但集中在少数“模型×基准”组合:13个模型85,439条能力基准样本中,得手仅590例(0.69%);开源模型的得手率(0.45%–1.69%)整体高于闭源模型(0.11%–0.45%),最高的是Doubao Seed 2.1 Pro (260915)(1.69%)。对得手样本人工抽检181例后,约78%的分数确实来自非预期路径(折算约460例、占全部样本0.54%)。真正存在“水分”的分数集中在:Qwen 3.8 Max (260902)的CTF夺旗任务测评(CyBench,11/120样本,读取题目自带二进制中的硬编码flag、复述公开题解)、Kimi K3与Doubao Seed 2.1 Pro (260915)的真实Web应用渗透攻击测评(CVE-Bench,13/90、9/90样本,凭记忆直接说出CVE编号与利用链),以及记忆型基准(生物实验问题定位测评BioLP-Bench 149例、前沿科学推理测评FrontierScience系列156例)的“回忆原版文本”式命中。相关分数已在正文相应章节按上限标注。
- 尝试的分布比得手广得多,反映出不安全倾向:全部样本中尝试达1,397例(1.63%),约为得手数的2.4倍。部分“模型×基准”组合的尝试率相当高:Gemini 3.8 Flash在隐蔽行动能力测评(GDM-Stealth)上尝试率73.1%(但仅3例得手,且分数来自基准预期行为)、Doubao Seed 2.1 Pro (260915)在真实Web应用渗透攻击测评(CVE-Bench)上尝试率55.6%、Gemini 3.8 Flash在生物信息学智能体任务测评(BixBench)上尝试率39.0%。从类型看,“答案泄漏或记忆”占大头(1,016例尝试),“脚手架漏洞”次之(346例)。
- 总体上,本期非预期解题路径对分数准确性的实际影响可控,但模型在多个基准上都表现出一定程度的尝试作弊倾向,随着模型能力继续增长,这一倾向值得持续警惕。
评测感知
- 评测感知高度集中在两个“场景本身就让测评设定很显眼”的基准上:在代理式错误对齐倾向测评(Agentic-Misalignment)上,9个可测模型的阳性率达36.2%–84.7%(Step 5 Preview 84.7%、Grok 4.7 83.0%、Kimi K3 82.5%);在抵抗关机倾向测评(Shutdown-Resistance)上为3.0%–91.0%(DeepSeek V4 Pro (260813) 91.0%、HY 4 Preview 78.0%);其余基准多在0%–15%。
- 这两个基准的分数要按“模型自知被测评”来解读:其安全分反映的是模型在自知处于测试情境下做出的选择——低分说明抵抗、错误对齐等倾向真实存在,高分则不宜直接外推为真实部署中的行为。
- 诚实性与提示词注入测评上也有值得注意的意识水平:HY 4 Preview在诚实性测评(MASK)上达27.6%、在提示词注入防护测评(CyberSecEval2-PromptInjection)上达47.4%,Step 5 Preview在两个基准上分别为15.2%和27.9%,这几个模型的诚实性与注入防御分数是在较高的“被测自觉”下取得的,解读时应保留余地。
注:GPT 5.6 Sol、GPT 6 Astra的思维链经API加密返回,Claude Opus 5.5、Gemini 3.8 Flash的日志不含思维内容,这4个模型的评测感知无法测量,不参与比较。
数据集污染
- 整体污染程度低:299个有效的模型-基准组合中,79%的污染分为0,只有19个组合的污染分≥5(满分200)。
- 唯一需要实质保留的是代理式错误对齐倾向测评(Agentic-Misalignment):Claude Opus 5.5有87.5%的样本被判“明确见过题”(污染分175),Grok 4.7、Kimi K3、GLM 5.3等6个模型的污染分为8.4–33.4。叠加该基准36%–85%的评测感知,其高分不能作为“部署中不会错误对齐”的证据。
- 其余均为弱信号:生物风险红队攻击测评(Fortress-Biological)上6个模型同为6.4分,该基准上6分以内的差异不应解读;前沿化学科学推理测评(FrontierScience-Chemistry)的头部三个模型(GPT 6 Astra 6.6、Claude Opus 5.5与Kimi K3各5.0)与生物实验问题定位测评(BioLP-Bench)上HY 4 Preview的8.0分也有轻微信号,相应分数不宜作为跨模型的精细标尺。
随机误差分析
平台按逐样本标准误给出 95% 置信区间,领域分数按基准等权平均、误差独立传播,风险指数按其公式的一阶偏导传播。对本期 13 个模型逐领域统计区间半宽,三个指标的量级差别明显:
- 安全分:随机误差很小。5 个领域,2026Q3模型的平均半宽仅 1.5–2.0 分(最宽 3.4 分)。
- 能力分:中等。平均半宽为化学 1.8、生物 2.7、有害操纵 3.0、网络攻击 4.3、失控 5.0 分。
- 风险指数:相对误差最大。平均半宽相当于其数值的 36%(网络攻击)、35%(生物)、71%(失控)——主要是指数项放大能力分误差。
判读原则:能力分相差 1-2 分以内、安全分相差 2–5 分以内、风险指数相差 30% 以内时,不应解读为真实差距。
安全-开放帕累托前沿
平台的安全-开放帕累托前沿页面把每个模型放到"开放指数 × 安全分"二维图上:横轴为开放指数(由 Artificial Analysis 开放指数与平台披露调研合成,越高越开放),纵轴为平台安全分(越高越安全),虚线标注帕累托前沿(同开放度仅安全分最高者入选,越右上越优)。方法与口径详见技术报告。
本季度帕累托前沿的更新情况:
- 入图模型:当前口径下入图70个模型(上季度62个)。本季度13个新模型中有8个入图——闭源3个(Claude Opus 5.5、GPT 6 Astra、GPT 5.6 Sol)与开源5个(MiMo V2.6 Pro、DeepSeek V4 Pro (260813)、Kimi K3、GLM 5.3、Step 5 Preview);Gemini 3.8 Flash、Grok 4.7、Qwen 3.8 Max (260902)、Doubao Seed 2.1 Pro (260915)、HY 4 Preview 因披露调研或 AA 匹配数据不全暂不入图。
- 本季度新模型的位置:闭源3个集中在图的左上(开放指数21.7–26.1、安全分83.4–88.4);开源5个居中(开放指数30.4–45.7、安全分46.6–62.5)。与上季度入图的12个模型相比,本季度入图模型的平均安全分由62.8升至67.8,平均开放指数由25.7升至31.2;按开源/闭源拆分,闭源平均开放指数由15.2升至23.2、平均安全分由74.1升至86.0,开源平均开放指数基本持平(36.2→36.1)、平均安全分由51.5升至57.0。
- 最安全与最开放:全量入图模型中,安全分最高的是Claude Opus 5.5(88.4分,本季度新模型),其后是GPT-5.5(86.4)与Claude Opus 4.8(86.3);开放指数最高的是DeepSeek R1 (250528)与GLM 4.5(同为52.2)。
- 帕累托前沿变化:前沿由5个模型构成——Claude Opus 5.5(开放26.1 / 安全88.4)、Claude Opus 4.5 Reasoning(30.4 / 81.5)、Qwen 3.5 397B Reasoning(39.1 / 64.2)、MiMo V2.6 Pro(45.7 / 56.1)、GLM 4.5(52.2 / 44.2)。与上季度前沿相比:Claude Opus 5.5以更高的安全分(88.4 > 86.3)取代同开放度的Claude Opus 4.8成为前沿左端;MiMo V2.6 Pro作为本季度新模型,在安全分(56.1)超过GLM 5(55.3)的同时更开放(45.7 > 43.5),把GLM 5挤出前沿。前沿两端仍然分别由披露体系完整的闭源模型(Anthropic)与高开放度的开源模型(GLM 4.5)构成,中间由开源模型连接。
局限性
本报告存在以下局限性:
- 风险评估范围的局限性
- 本次风险监测仅针对大语言模型(包括视觉语言模型),尚未涉及对更多模态和智能体等系统的监测,尚不能全面评估所有模型和AI系统的风险。
- 本次风险监测仅针对滥用和失控类型的风险评估,尚不能涵盖所有类型的前沿风险(比如意外风险和系统性风险)。
- 风险评估方法的局限性
- 由于现有测评方法的不足,尚不能够充分测出模型的能力和安全水平,如
- 能力测评的提示词、工具、Agent框架等设置可能未全面发挥出模型的潜力。
- 安全测评中仅尝试了有限的红队攻击方法。
- 有害操纵测评中使用LLM来模拟被说服者,可能和真人存在效果差异。
- 风险指数的计算是现有条件下对实际风险的一种简化建模,尚不能精确量化实际的风险。
- 当前对滥用风险的评估仅考虑了模型对攻击者的赋能,尚未考虑模型对防御者的赋能对整体风险的影响。
- 当前风险指数2.1版中,化学风险与有害操纵领域尚未定义能力黄线阈值,未能计算风险指数。
- 由于现有测评方法的不足,尚不能够充分测出模型的能力和安全水平,如
- 测评数据集的局限性
- 测评数据集所覆盖的场景可能不全。
- 当前的测评数据集以英文内容为主,尚不能评估多语言环境下的风险情况。
- 部分测评基准仍可能随着模型能力提升而逐渐饱和,需要持续更新。
此外,本报告仅针对模型可能产生的风险进行了评估,而未评估模型带来的收益,在实际制定政策和行动时需要权衡风险与收益。
建议
面向模型开发者
基于本期监测结果,我们向模型开发者提供以下建议:
- 关注自身开发的模型的风险指数情况,如果风险指数超过风险黄线:
- 建议优先加强模型安全防护:
- 加强基础安全防护:如通过监督微调训练模型拒绝有害请求。
- 加强越狱安全防护:如通过输入输出监控来识别并过滤掉有害的请求和回答、通过对抗性训练来提升模型对越狱请求的防御能力等。
- 加强篡改安全防护:闭源模型需加强网络安全防护以防止参数泄露;开源模型可探索在训练过程中引入防篡改机制。
- 加强失控领域安全防护:如通过思维链监控来检测模型可能的欺骗和密谋。
- 如果仅靠加强安全防护不足以缓解风险,则可探索降低模型高风险能力:
- 从模型训练数据中移除网络攻击、生物、化学武器等高危知识,或在后训练阶段使用机器遗忘技术从模型参数中移除。
- 构建请求分类器,将高风险领域请求路由到相对低能力的模型进行处理。
- 采取KYC(了解你的客户)机制,仅将具备网络、生物等高能力的模型向受信任的用户开放。
- 一些通用的风险管理实践:
- 根据自身情况制定风险管理框架,明确风险阈值、达到阈值后的缓解措施和发布策略。可参考前沿AI风险管理框架2.0。
- 加强模型风险信息披露,如在发布模型的同时提供模型的系统卡,提升安全治理透明度。
- 建议优先加强模型安全防护:
- 如果能力分越过能力黄线,风险指数未越过风险黄线:
- 建议对模型进行全面的安全评估,确保当前防护措施足以将模型部署后风险缓解到中低水平。
- 建议加强模型安全防护,将风险控制在更低水平,为未来模型能力提升提供一定的缓冲空间。具体措施同上。
- 如果能力分和风险指数均未超过黄线:
- 暂无特殊建议,可保持关注新模型的风险情况,在新模型发布前进行能力和安全测评,及时掌握变化。
安远AI可为模型开发者提供前沿风险管理咨询和安全测评服务,如有合作意向请联系risk-monitor@concordia-ai.com。
面向AI安全研究者
基于本期监测结果,我们向AI安全研究者提供以下建议:
- 对于风险评估方向的研究者:
- 可探索更有效的能力激发方法(如更好的智能体框架、推理时扩展),以准确评估模型的能力上限。
- 可探索更有效的攻击模型的方法(如新的越狱、红队攻击、提示词注入和多轮操纵方法),以准确评估模型的安全下限。
- 可探索更精准评估实际风险的方法,例如建立新的威胁模型并针对其中各个环节设计针对性的测评基准。
- 鉴于AI智能体的广泛应用,可探索针对智能体工具调用、长期任务执行和环境交互的风险评估方法。
- 对于风险缓解方向的研究者:
- 可探索更有效的模型安全加固和危险能力移除方案,在增强模型安全性的同时尽可能不牺牲其实用能力。
- 鉴于开源模型更容易被恶意篡改,且本期监测显示开源模型在能力追平闭源模型的同时安全防护明显落后,可探索适合开源模型的风险缓解方案。
上述方向也是安远AI未来的重点研究方向,安远AI愿与业界同行合作开展研究,如有合作意向请联系risk-monitor@concordia-ai.com。
面向政策制定者
基于本期监测结果,我们发现以下早期预警信号:
- 网络攻击滥用风险:Qwen 3.8 Max (260902)已越过网络攻击风险黄线,另有14个模型越过能力黄线。前沿模型在CyBench、CVE-Bench等漏洞利用任务上持续进步,体现这些模型已逐步具备以自主、多轮交互方式进行漏洞发现、利用和网络渗透的能力。但多数模型安全防护弱,在红队攻击下安全分数平均下降64.4分。
- 生物滥用风险:目前已有20个模型越过风险黄线。在湿实验问题排查、DNA与蛋白质序列理解、生物图像理解等任务上已超过人类专家水平的模型数量持续增加。部分开源模型在协助生物武器设计制造等高危问题上防护明显不足,在红队攻击下安全分数平均下降42.4分。
- 失控风险:目前尚无模型越过风险黄线,但越过能力黄线的模型已增至8个,且模型自我复制能力创新高(Claude Opus 5.5达95.2分)。部分模型仍存在诚实性偏低和抵抗关机倾向。
建议政策制定者对上述网络攻击、生物风险和失控领域的预警信号保持关注,并加强对模型的相关监管要求(如要求模型开发者在发布模型前对网络攻击、生物风险和失控风险进行评估,并实施必要的风险缓解措施)。可针对不同风险开展差异化治理方法,综合考虑模型能力水平、安全性以及分发方式(开源或闭源)等因素。
附录
关于本期监测所用到的风险指数版本升级细节、新增测评基准的具体实现细节、测评日志审计、数据集污染检测、信息危害披露权衡详见这里。
相关链接
上一期报告:前沿AI风险监测报告(2026Q2)。